Bild-OCR – online & kostenlos
OCR auf ein Bild anwenden, online: Text aus einem Foto oder Scan extrahieren, kostenlos.
oder einfach irgendwo hier ablegen
Mehrere Dateien · bis zu 260 MB pro Datei · nach der Verarbeitung gelöscht
Dateien hier ablegen
oder
Dateien auswählen- Belege, Screenshots, Fotos von Seiten
- Bis zu 260 MB pro Datei
Sicher über HTTPS verarbeitet. Dateien werden nach der Verarbeitung gelöscht.
„Bild-OCR“ liest die Wörter in einem Bild und gibt sie Ihnen als Text zurück, den Sie kopieren können. So sparen Sie sich das Abtippen, wenn Sie ein Foto eines Belegs für die Spesenabrechnung, einen Screenshot einer Fehlermeldung oder ein Handyfoto einer Seite aus einem Bibliotheksbuch haben.
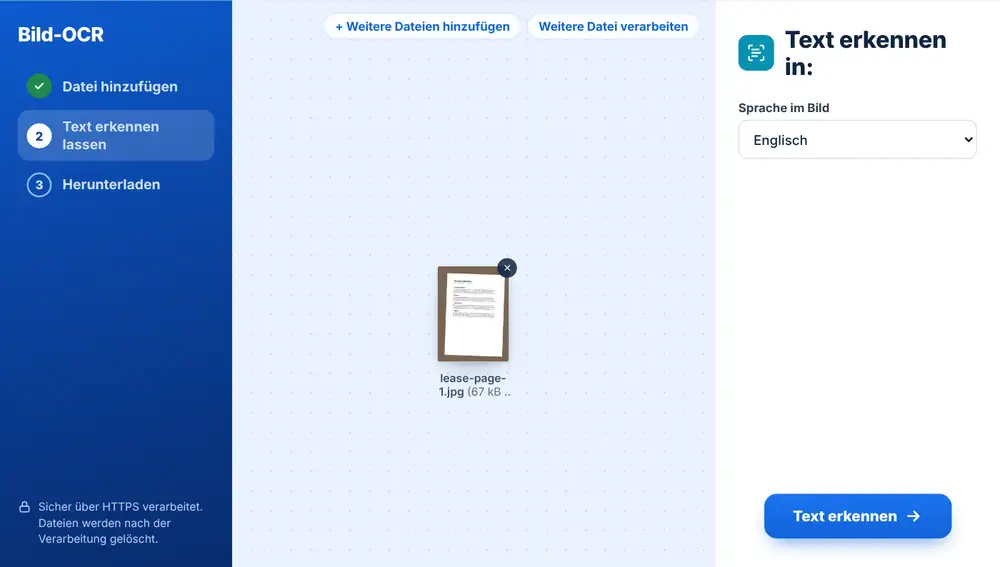
Text aus Bild erkennen – so geht’s
Fügen Sie ein oder mehrere Bilder von Ihrem Gerät, aus Google Drive, Dropbox oder OneDrive hinzu. Belege, Screenshots und Fotos von Seiten funktionieren gleichermaßen, in JPG, PNG, HEIC und anderen gängigen Formaten. Wählen Sie die Sprache im Bild, klicken Sie auf „Text erkennen“, und die Wörter erscheinen auf dem Bildschirm – mit der Angabe, wie viele gefunden wurden –, bereit zum Einfügen in eine E-Mail, eine Tabelle oder eine Notiz.
Die richtige Sprache für die Bild-OCR wählen
Die Sprachliste umfasst Englisch, Arabisch, Französisch, Deutsch, Spanisch, Portugiesisch und Chinesisch (vereinfacht). Voreingestellt ist die Sprache Ihres Browsers – wer einen arabischen Browser nutzt, sieht also Arabisch ausgewählt –, Sie können sie aber für jeden Vorgang ändern.
Liest man eine arabische Speisekarte mit Englisch als Einstellung, erhält man Ketten seltsamer Zeichen. Sieht das Ergebnis also unverständlich aus, ändern Sie die Sprache und starten Sie erneut.
So wird der Text aus einem Foto sauberer
Fotografieren Sie die Seite gerade von vorn, bei gleichmäßigem Licht, sodass der Text den Großteil des Bildes ausfüllt. Zerknitterte Belege und Spiegelungen auf Glanzpapier sind die üblichen Störenfriede. Ein kurzer Durchgang durch „Bild verbessern“ mit der Einstellung „Scan / Text schärfen“ kann bei einem blassen oder körnigen Foto helfen.
Meldet das Tool „Kein Text gefunden“, versuchen Sie es mit einem schärferen Foto oder einer anderen Sprache. Bei einem mehrseitigen Dokument fassen Sie die Fotos mit „Bild in PDF“ zu einer Datei zusammen und nutzen dann „PDF-OCR“ – damit bleiben die Seiten erhalten, und jede bekommt durchsuchbaren Text.
Häufige Fragen
- Was kann die Bild-OCR lesen?
- Gedruckten Text in Fotos und Screenshots: Belege, Visitenkarten, Schilder, Buchseiten, in der Vorlesung fotografierte Folien. Klarer Druck funktioniert deutlich besser als Handschrift.
- Welche Sprachen unterstützt die Bild-OCR?
- Englisch, Arabisch, Französisch, Deutsch, Spanisch, Portugiesisch und Chinesisch (vereinfacht). Wählen Sie die Sprache des Textes, bevor Sie auf „Text erkennen“ klicken.
- Kann ich Text aus mehreren Bildern auf einmal auslesen?
- Ja. Fügen Sie einen Stapel Bilder hinzu, und jedes wird nacheinander gelesen, jeweils mit einem eigenen Textblock.
- Was bekomme ich am Ende?
- Reinen Text auf der Seite, den Sie überall hinein kopieren können. Es wird kein neues Bild und kein PDF erstellt.
- Warum wurde kein Text gefunden?
- Meist ist das Foto unscharf oder zu dunkel, oder es ist die falsche Sprache ausgewählt. Fotografieren Sie näher und gerader oder ändern Sie die Sprache und versuchen Sie es erneut.
- Bild-OCR oder PDF-OCR – was ist das Richtige?
- Nehmen Sie „Bild-OCR“, wenn Sie einfach nur die Wörter aus einem Bild brauchen. Nehmen Sie „PDF-OCR“, wenn Sie ein gescanntes PDF haben und es als PDF behalten möchten, in dem Sie suchen und Text markieren können.